2026. 9. 10. 07:37
반응형
AGI와 프로젝트 아스트라(Project Astra)는 각각 범용 인공지능과 구글의 차세대 멀티모달 AI 프로젝트를 의미합니다.
약어 풀네임
- AGI: Artificial General Intelligence (범용 인공지능)
- Astra: 특정 약어가 아닌, 라틴어로 "별"을 뜻하는 구글의 AI 프로젝트 명칭 (Project Astra)
정의
- AGI (범용 인공지능): 특정 영역(바둑, 번역 등)만 잘하는 기존 AI(특화형 AI)와 달리, 인간처럼 다양한 영역의 지식을 스스로 학습하고 추론하며 문제 해결할 수 있는 만능 AI를 뜻합니다.
- 프로젝트 아스트라 (Project Astra): 구글 딥마인드가 개발한 실시간 범용 비전·음성 AI 에이전트입니다. 스마트폰 카메라나 스마트 글래스를 통해 AI가 눈으로 세상을 실시간 인식하고, 사용자와 자연스럽게 대화하며 도울 수 있도록 설계되었습니다.
실사용 사례
- 잃어버린 물건 찾기: 카메라로 방 안을 비추며 다니면, 아스트라가 방 내부를 기억해 두었다가 "내 안경 어디 뒀지?"라고 물었을 때 "아까 서랍 옆 빨간 컵 뒤에 두셨어요"라고 즉시 안내합니다.
- 실시간 복잡한 코드·도면 해석: 모니터의 복잡한 프로그래밍 코드를 카메라로 비추면, 문제점이 있는 위치를 실시간으로 찾아내어 말로 설명해 줍니다.
- 현장 사물·시스템 즉시 설명: 도로 위의 특정 장비나 시스템을 비추며 "이 부품이 무슨 역할을 해?"라고 물으면 멈춤 없이 즉각 작동 원리를 대화로 풀어 설명합니다.
참고-용어 설명)
- 범용 비전 (Vision): '비전'은 카메라를 통해 AI가 눈으로 보는 기능을 뜻합니다. 단순히 글자나 얼굴만 인식하는 수준을 넘어, 사람처럼 주변 환경·물체·동영상 등 화면에 찍히는 모든 시각 정보를 종합적으로 이해할 수 있다는 의미에서 '범용'이라는 표현을 씁니다.
- 음성 AI 에이전트 (Agent): '에이전트'는 말씀하신 대로 사람을 대신해 업무를 처리해 주는 대리인(비서)을 뜻합니다. 텍스트를 입력할 필요 없이 사람처럼 음성으로 자연스럽게 대화하며 사용자의 요청을 처리해 주는 인공지능 비서입니다.
쉽게 한 문장으로 정리하면
"컴퓨터 화면이나 카메라로 세상을 직접 보면서, 사람처럼 말로 주고받으며 일을 도와주는 똑똑한 인공지능 비서"입니다.
기존 AI 비서와의 차이점
| 구분 | 기존 AI 비서 (시리, 아리 등) | 실시간 비전·음성 AI 에이전트 |
| 인식 방식 | 음성 명령 입력만 인식 | 카메라 시각 + 음성 동시에 인식 |
| 반응 속도 | 대화 시 약간의 딜레이 발생 | 사람과 대화하듯 실시간 대응 |
| 상황 이해 | "오늘 날씨 어때?" 같은 단답형 | "내가 지금 보고 있는 이 코드 에러 좀 찾아줘" 같은 복잡한 맥락 이해 |
카메라로 화면이나 주변을 비추기만 하면, 별도의 설명 없이도 AI가 상황을 '보고 이해한 상태'에서 음성으로 바로 도움을 줄 수 있는 것이 핵심입니다.
추가설명) 음성·시각 인식을 넘어 상황을 판단하고 행동하는 'AI 에이전트'의 작동 구조
스스로 판단하고 작업을 수행하는 AI 에이전트는 인간이 감각을 통해 정보를 받아들이고 뇌로 생각한 뒤 몸을 움직여 행동하는 방식과 동일한 구조로 작동합니다.
AI 에이전트의 내부 구조는 크게 4가지 핵심 모듈로 구성됩니다.
AI 에이전트의 4대 핵심 구조
- 감각 모듈 (Perception / Inputs): 인간의 눈과 귀 역할을 합니다. 카메라(시각), 마이크(음성), 센서, 웹 데이터, 문서 파일 등 외부 세상의 데이터를 실시간으로 받아들여 디지털 데이터로 변환합니다.
- 뇌·지능 모듈 (Brain / LLM & Multi-Modal): 에이전트의 중심부입니다. 대형 언어 모델(LLM)이나 멀티모달 모델이 탑재되어 입력받은 상황을 해석하고, 사용자의 목표를 달성하기 위한 추론(Reasoning)과 계획 수립(Planning)을 진행합니다.
- 기억 모듈 (Memory): 단기 기억(현재 진행 중인 대화나 작업 맥락)과 장기 기억(과거 사용자의 취향, 이전 작업 결과, 외부 DB)으로 나뉩니다. 필요한 순간 과거 데이터를 불러와 맥락을 유지하고 일관된 판단을 내리게 돕습니다.
- 행동 모듈 (Action / Tools & Actuators): 판단된 결과를 바탕으로 실행에 옮기는 손과 발 역할입니다. API 호출, 프로그램 클릭, 데이터베이스 조회, 메일 발송, 로봇 팔 제어 등 실제 작업을 수행합니다.
실제 작동 원리 (4단계 프로세스)
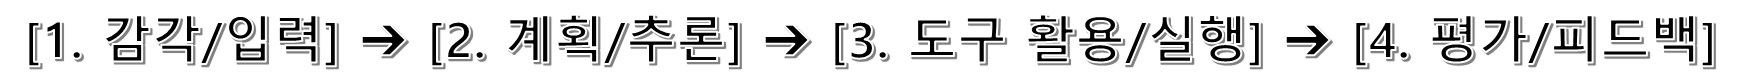
- 상황 인식 및 목표 수립: 사용자가 "다음 주 출장 일정에 맞춰 KTX 예매하고 관련 자료 요약해 줘"라고 요청하면, 감각 모듈이 음성과 캘린더 화면을 받아들여 최종 목표를 설정합니다.
- 작업 분하 (Planning): 뇌 모듈이 복잡한 목표를 소작업으로 쪼갭니다.
- 1단계: 캘린더에서 출장 날짜와 시간 확인
- 2단계: KTX 앱 접속 및 최적의 시간대 열차 검색
- 3단계: 출장 관련 문서 로드 및 요약본 작성
- 도구 선택 및 실행 (Action & Tools): 기억 모듈에서 기존 선호 좌석 데이터를 불러온 뒤, API와 자동화 도구를 사용해 열차를 예약하고 요약 문서를 생성합니다.
결과 평가 및 피드백 (Feedback Loop): 실행 중 오류(예: 원하는 시간대 좌석 품절)가 발생하면 스스로 다른 대안 시간대를 찾아 수정한 뒤, 최종 완료 내역을 사용자에게 음성이나 화면으로 보고합니다.
반응형
'AI 관련 모음' 카테고리의 다른 글
| AI 에이전트의 의미와 AI 에이전트가 사용하는 추론 프레임워크(ReAct등)에 대한 내용 (0) | 2026.09.10 |
|---|---|
| 스마트홈 케어 IoT센서와 통신기술결합 및 환자 안전 상태 모니터링 (0) | 2026.09.07 |
| 구글의 제미나이(Gemini)와 오픈AI의 챗GPT(ChatGPT)는 서로 완전히 다른 데이터센터 이용 (0) | 2026.08.29 |
| 인공지능 데이터센터 유치하면 인구 유입 규모에 대해 메모 (1) | 2026.08.25 |
| 인공지능(AI) 데이터센터 월(月) 운영비 정리 (0) | 2026.08.23 |
콘텐츠 내 자동삽입광고